5 estratégias de cache distribuído na prática
Toda aplicação com um mínimo de tráfego chega nessa pergunta: por que bater no banco de novo pra buscar um dado que não mudou desde a última consulta? Cache é a resposta óbvia. O problema é que “usar cache” não é uma decisão única: é uma família de estratégias, cada uma com um trade-off diferente entre performance, consistência e risco de perda de dado.
Neste post: o que é cache distribuído (e por que “distribuído” importa), e as 5 estratégias mais usadas na prática pra decidir quando gravar e quando invalidar.
O que é cache, e por que “distribuído”
Cache é guardar um dado num meio de acesso rápido pra evitar buscar de novo numa origem mais lenta: banco de dados, API externa, um cálculo caro. A ideia é simples; a complexidade está em decidir quando gravar, quando invalidar, e o que fazer num miss.
A palavra “distribuído” aparece porque existem duas formas bem diferentes de implementar isso:
- Cache local (in-process): vive na memória da própria aplicação, um array estático, algo como o APCu no PHP. Rápido, mas preso àquela instância. Se você sobe 5 réplicas do mesmo serviço atrás de um load balancer, cada uma tem sua própria cópia, fora de sincronia com as outras.
- Cache distribuído: vive num serviço externo, compartilhado: Redis, Memcached. Todas as instâncias da aplicação enxergam o mesmo dado. É o que faz sentido assim que o sistema deixa de rodar numa instância só.
Redis é a escolha mais comum pra isso: um key-value store em memória, rápido o bastante pra virar gargalo raramente, com suporte nativo a expiração de chave (TTL), essencial pra qualquer estratégia de cache, porque sem TTL um dado errado fica errado pra sempre.
O laboratório: cache-distribuido
Montei um repositório com PHP 8.4 + Redis, tudo em Docker, com um script executável pra cada uma das 5 estratégias abaixo. Não vou colar código aqui: o post é sobre entender o conceito de cada uma. Os exemplos completos (e um wrapper simples sobre o Redis, com set/get/delete) estão no repositório, prontos pra rodar com docker compose up -d --build.
As 5 estratégias
Cache Aside (Lazy Loading)
A pergunta: o dado está no cache? Se sim, retorna. Se não, busca na origem, grava no cache, e só então retorna.
- App pergunta ao cache pela chave
- Se existir (hit) → retorna direto do cache
- Se não existir (miss) → busca na origem, grava no cache, retorna
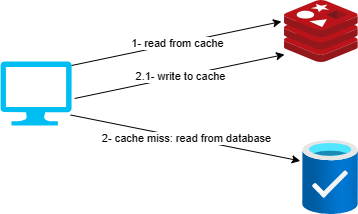
É a estratégia padrão pra maioria dos casos: resiliente a falha do cache (se o Redis cair, a app continua funcionando lendo direto da origem) e só guarda em cache o que de fato é lido. O custo é a primeira leitura de cada chave, sempre um miss, e uma janela pequena de dado desatualizado até a próxima escrita.
Write Through
A pergunta: toda escrita precisa aparecer no cache imediatamente? Então grava nos dois ao mesmo tempo, de forma síncrona.
- App grava no cache
- App grava na origem
- (as duas fazem parte da mesma operação de escrita)
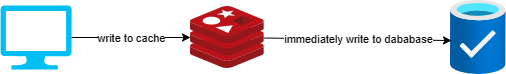
Garante que o cache nunca fica desatualizado em relação à origem, ao custo de toda escrita ficar um pouco mais lenta, já que paga o preço das duas gravações. Faz sentido quando consistência importa mais que latência de escrita: um dado que vai ser lido logo em seguida e não pode estar velho.
Write Back (Write Behind)
A pergunta: e se a escrita na origem não precisar ser síncrona? Grava rápido no cache, e persiste na origem depois, em background.
- App grava no cache (rápido, síncrono)
- Um processo separado, mais tarde, persiste na origem (assíncrono)
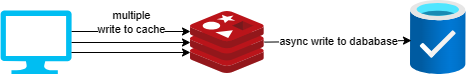
Escrita muito rápida, ótimo pra cenário write-heavy (onde o volume de escritas é muito maior que o de leituras). O risco: se o cache cair antes do processo assíncrono persistir, essa escrita se perde. Por isso o padrão só é seguro pra dado reconstruível, ou onde uma perda ocasional é aceitável. A parte assíncrona (fila, worker, cron) fica a cargo de quem for usar o padrão em produção.
Write Around
A pergunta: e se a escrita nem precisar passar pelo cache? Grava direto na origem, e deixa o cache ser populado só quando alguém realmente ler.
- App grava direto na origem (não mexe no cache)
- Numa leitura futura: cache miss → busca na origem → agora sim grava no cache
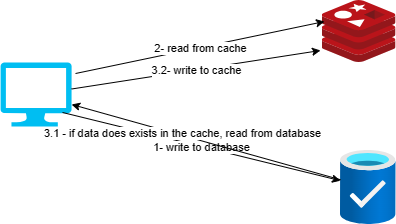
Na prática é uma combinação: “escrita direto na origem” com “leitura no padrão Cache Aside”. Bom pra dados escritos com frequência mas raramente lidos logo em seguida: evita poluir o cache com algo que talvez nunca seja lido.
Pre Caching (warm-up)
A pergunta: por que esperar o primeiro miss, se já dá pra saber o que vai ser pedido? Carrega o cache antecipadamente, antes de qualquer requisição real.
- Job de warm-up roda (deploy, cron, start da app)
- Preenche o cache com os dados que se sabe que serão pedidos
- Quando a app pedir, já é sempre hit
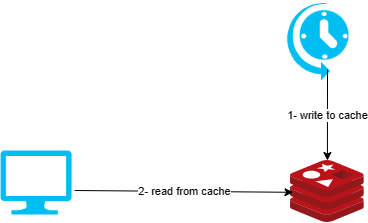
Elimina o cache miss inicial que as outras estratégias têm: a primeira requisição já chega quente. Faz sentido pra dados previsíveis: catálogo de produtos, configuração, tabelas de referência que mudam pouco.
Resumo
| Estratégia | Quando grava no cache | Consistência | Risco principal |
|---|---|---|---|
| Cache Aside | Na primeira leitura (miss) | Eventual | Primeira leitura sempre lenta |
| Write Through | Na escrita, síncrono com a origem | Forte | Escrita mais lenta |
| Write Back | Na escrita, só no cache | Eventual (origem atrasada) | Perda de dado se o cache cair antes de persistir |
| Write Around | Na primeira leitura após a escrita | Eventual | Mesmo custo de miss do Cache Aside |
| Pre Caching | Antes de qualquer leitura (warm-up) | Depende do job de warm-up | Cache desatualizado se o dado mudar entre warm-ups |
Não existe “a melhor”. Cache Aside cobre a maioria dos casos como padrão default. Write Through entra quando staleness é bug de verdade. Write Back só é seguro pra dado reconstruível ou onde perda ocasional é aceitável. Write Around evita lixo no cache quando a escrita é muito mais frequente que a leitura. Pre Caching resolve o problema específico do miss inicial, quando dá pra prever o que vai ser pedido.
Fechando
Cache resolve um problema real, mas “colocar um Redis na frente” não é a parte difícil: a parte difícil é escolher a estratégia certa pra cada tipo de dado e de acesso. Um catálogo que muda pouco pede Pre Caching. Uma escrita que precisa refletir na próxima leitura pede Write Through. Um contador que aguenta perder um evento ocasional pode ser Write Back. A maioria do resto começa em Cache Aside.
O código de cada estratégia, mais o setup completo em Docker, está no repositório github.com/wander4747/cache-distribuido.